目次
「返信を忘れているメールを、AIに見つけてほしい」——生成AIが身近になり、こうした発想は自然に出てきます。私たちRENOYも、返信漏れの検出をAIに任せる仕組みを自社で作りました。
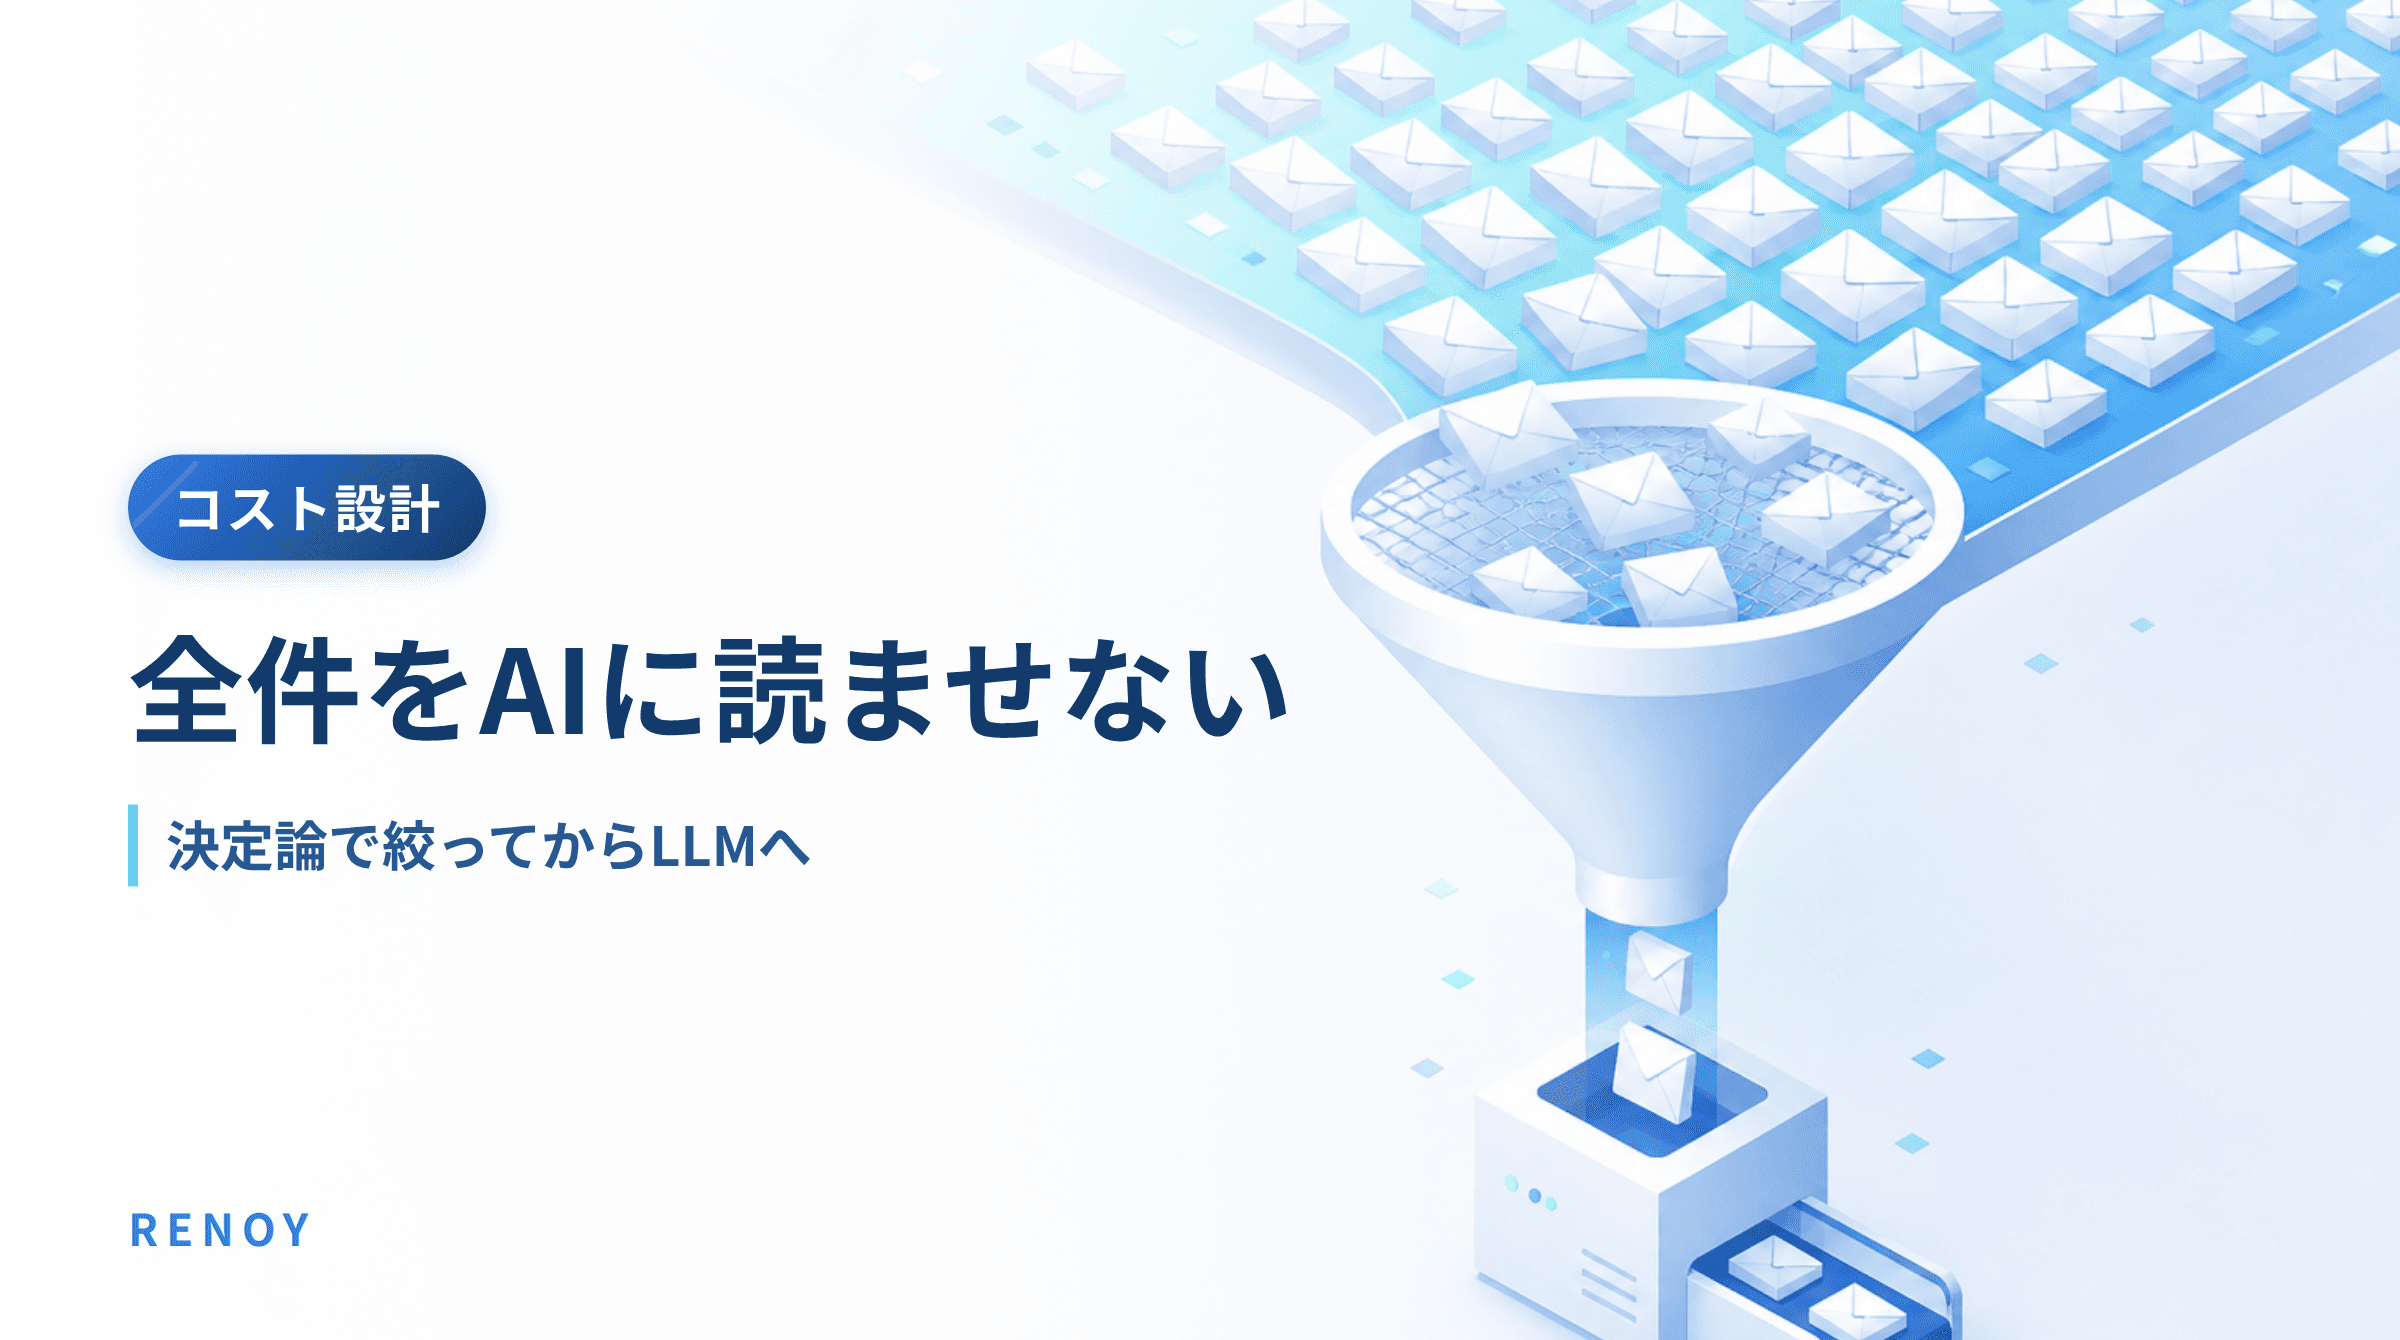
作り始めてすぐに分かったのは、すべてのメールをLLM(大規模言語モデル)に読ませる作りでは費用が合わないということです。受信箱の中身の多くは、広告や各種サービスからの通知です。全件をAIに通すと、返信とは関係のない「ジャンクの仕分け」にまでAIの費用を払うことになります。
この記事では、私たちが採った2層の設計と、運用で効いてくる除外リストの置き場所について整理します。
この記事の結論
- 全メールをLLMに通すと、ジャンク仕分けにAI費用を払うことになる
- 前段のルールで候補を絞り、最終判定だけをLLMに渡す
- 除外リストはコードの外に出し、運用側が直接更新する
LLMで全メールを判定するとコストが合わない原因
LLMは、文章の意味を読み取って判断するのが得意です。「このメールは返信が必要か」という問いにも、それなりの精度で答えられます。
問題は、その判断をどのメールに対して行うかです。受信するメールには、返信の要否を考えるまでもないものが大量に含まれます。
- 広告・メールマガジン
- 各種サービスからの自動通知
- システムが送ってくる定型の案内
こうしたメールは、人が見れば一瞬で「返信不要」と分かります。それでも全件をLLMに渡す作りにすると、1通ごとにAIを呼び出す費用がかかります。つまり、本来やりたい「返信漏れの検出」ではなく、ジャンクの仕分け作業に対してお金を払い続ける構造になってしまうのです。
LLMの利用料金は、呼び出す量に応じてかかる形が一般的です。料金体系や条件はサービスごとに異なり、変わることもあるため、最新は各社の公式情報で確認してください。
LLMのコスト対策:決定論で絞り、最終判定だけAIへ
そこで採ったのが、処理を2層に分ける構成です。
1層目は、決定論的なルールによる絞り込みです。決定論的とは、同じ入力に対して必ず同じ結果を返す、という意味です。「この送信元からのメールは除外する」といった、機械的に判断できる処理をここで行います。ルールによる処理にはAIの費用がかかりません。
2層目で、残った「返信が必要になり得る候補」だけをLLMに渡し、最終判定を任せます。文脈を読まないと判断できない部分にだけ、AIを使うということです。
| 層 | 担当 | 得意なこと | 費用 |
|---|---|---|---|
| 1層目 | 決定論的なルール | 機械的に判断できる除外 | かからない |
| 2層目 | LLM | 文脈を読んだ最終判定 | 呼び出し量に応じてかかる |
ポイントは、AIに渡す前段で件数を落とす設計にすることです。AIの精度をどう上げるかより先に、そもそもAIに何を渡すかを決める。これだけで、費用の構造が大きく変わります。
除外ルールの設計:1件・送信元・パターンの3層
1層目の除外は、1種類のルールで済ませず、粒度の違う3層に分けました。
| 除外の単位 | 内容 | 向いているケース |
|---|---|---|
| 1件単位 | 特定のメールを個別に除外 | 一度きりの例外的なメール |
| 送信元単位 | 特定の送信元からのメールをまとめて除外 | 決まった相手から届く通知・広告 |
| パターン単位 | 件名や文面の型に当てはまるものを除外 | 送信元は様々でも形が決まっているメール |
粒度を分けておくと、除外の判断が雑になりません。送信元単位でまとめて外せるものはまとめて外し、送信元は同じでも返信が必要なメールが混じる場合は、パターン単位や1件単位で細かく扱えます。
逆に、1種類のルールだけで除外しようとすると、「外しすぎて大事なメールを見落とす」か「外し足りずにAIの費用がかさむ」かの二択になりがちです。
除外リストはスプレッドシートへ:チューニング対象をコードの外に置く
もう一つ、運用で大きく効いたのが、除外リストの置き場所です。
除外リストは、コードの中に埋め込まず、スプレッドシートに出しました。運用する側が直接開いて、送信元やパターンを追加・削除できる形です。
理由はシンプルで、除外したいメールは日々変わるからです。新しいサービスからの通知が届き始めたり、広告の文面が変わったりするたびに、除外リストの調整が必要になります。
これがコードの中にあると、調整のたびに開発者へ依頼し、修正してもらう必要があります。手間がかかる分、調整は後回しになり、やがてAIに渡る件数がじわじわ増えていきます。チューニングの対象をコードの外に置くことで、運用側が気づいたその場で直せるようになり、仕組みの精度と費用を保ちやすくなります。
他の業務にも使える判断軸
今回はメールの返信漏れ検出の例ですが、この考え方はAIを業務に組み込む場面に広く当てはまります。持ち帰っていただきたい判断軸は2つです。
- AIに渡す前段で件数を落とす:機械的に判断できるものはルールで処理し、AIには本当に判断が必要なものだけを渡す
- チューニング対象をコードの外に置く:日々調整が必要な設定は、運用側が直接触れる場所に出しておく
「AIに全部任せる」は分かりやすい構想ですが、費用と運用の両面で無理が出やすい形でもあります。ルールとAIの役割分担を先に決めておくことが、長く使える仕組みへの近道です。
まとめ
- 全メールをLLMに通す作りでは、ジャンクの仕分けにまでAIの費用を払うことになる
- 決定論的なルールで候補を絞り、最終判定だけをLLMに渡す2層設計にする
- 除外は1件単位・送信元単位・パターン単位の3層に分けると、外しすぎも外し足りなさも防げる
- 除外リストはコードに埋めず、スプレッドシートに出して運用側が直接更新できるようにする
よくある質問
Q. メールの返信漏れ検出をLLMで行うと、費用はどうなりますか? 全件をLLMに通す作りでは、広告や通知などのジャンクを仕分けるためにもAIの費用を払うことになります。前段のルールで返信が必要になり得る候補に絞り、最終判定だけをLLMに渡すと、無駄な呼び出しを減らせます。
Q. 決定論的なルールとLLMは、どう使い分ければよいですか? 機械的に判断できる除外はルールで処理し、文脈を読まないと判断できない最終判定だけをLLMに任せます。ルールは同じ入力に同じ結果を返し追加費用もかからないため、LLMは本当に判断が必要な候補に集中できます。
Q. メール判定の除外リストは、どこで管理するのがよいですか? コードに埋め込まず、スプレッドシートなど運用側が直接編集できる場所に置くのがおすすめです。除外したい送信元や文面は日々変わるため、開発者を介さずに更新できると、チューニングが止まらず精度を保ちやすくなります。
RENOYでは、生成AIを業務に組み込む際に「どこまでをルールで処理し、どこからをAIに任せるか」という設計から、無料相談で承っています。「AIを使いたいが、費用がどれくらいかかるか見当がつかない」という段階のご相談も歓迎です。まずはお気軽に無料個別相談(オンライン・60分)をご利用ください。サービス内容をまとめた資料は資料請求からご覧いただけます。